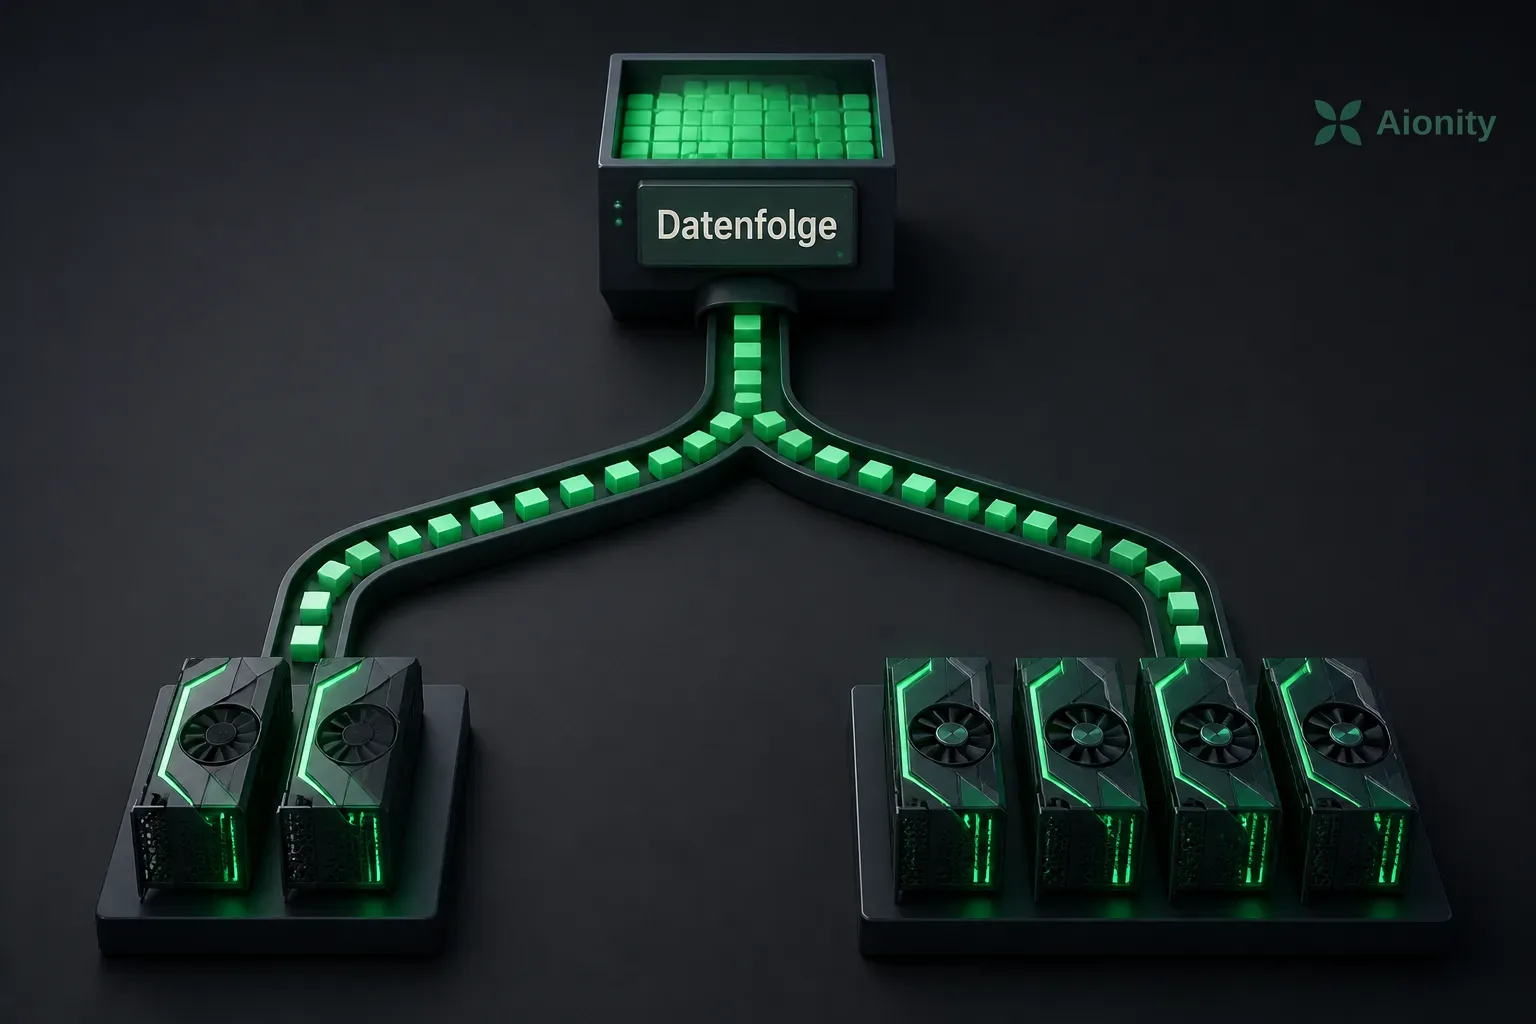
Änderungen an Datenmischungen, Filtern oder Tokenisierung erfordern oft eine vorbereitete Kopie des Trainingskorpus. Laut PyTorch kann das viel Rechenzeit und Speicher beanspruchen, obwohl ein Trainingslauf diese Kopie typischerweise nur einmal liest. Zephon erledigt die Datenaufbereitung stattdessen während des Trainings: Es tokenisiert, packt, mischt und ordnet die Daten, ohne dass dafür vorab ein vollständig verarbeitetes Korpus erstellt werden muss.
PyTorch vergleicht Zephon mit einem herkömmlichen Data Loader anhand eines 1B-Parameter-Modells in TorchTitan. Ein Lauf startet auf 16 GPUs und wird bei Schritt 150 aus einem Checkpoint fortgesetzt – auf 8, 32 und 64 GPUs. Mit dem Standard-Loader verändert sich nach dem Wechsel die Reihenfolge der Samples. Bei Zephon stimmen laut PyTorch die SHA-256-Hashes aller globalen Batches mit dem ursprünglichen Lauf überein; auch die dargestellten Loss-Kurven liegen übereinander.
Ein zweiter Versuch trainiert dasselbe Modell von Grund auf mit 20B Tokens auf 8, 16, 32 oder 64 GPUs. Beim Standard-Loader unterscheiden sich die Ergebnisse auf DCLM Core v1 um bis zu 0,82 Punkte und in der FineWeb-Evaluierung um bis zu 0,64 Punkte. PyTorch gibt für Zephon über die GPU-Zahlen hinweg Abweichungen von 0,05 beziehungsweise 0,011 Punkten an. Damit sollen Vergleiche von Datenmischungen weniger davon abhängen, wie viele GPUs gerade für einen Lauf eingesetzt werden.
Für die Konfiguration beschreibt man in Zephon die Datensätze, eine WorkSource für Mischung und Reihenfolge sowie eine Pipeline mit Verarbeitungsschritten. Das Beispiel von PyTorch kombiniert zwei Textdatensätze von Hugging Face zu gleichen Token-Anteilen und führt sie durch Tokenisierung, Packen, Mischen und Batching. Die WorkSource legt dabei das Trainingscurriculum anhand der Metadaten der Datensätze fest; die Pipeline verarbeitet die Samples weiter.