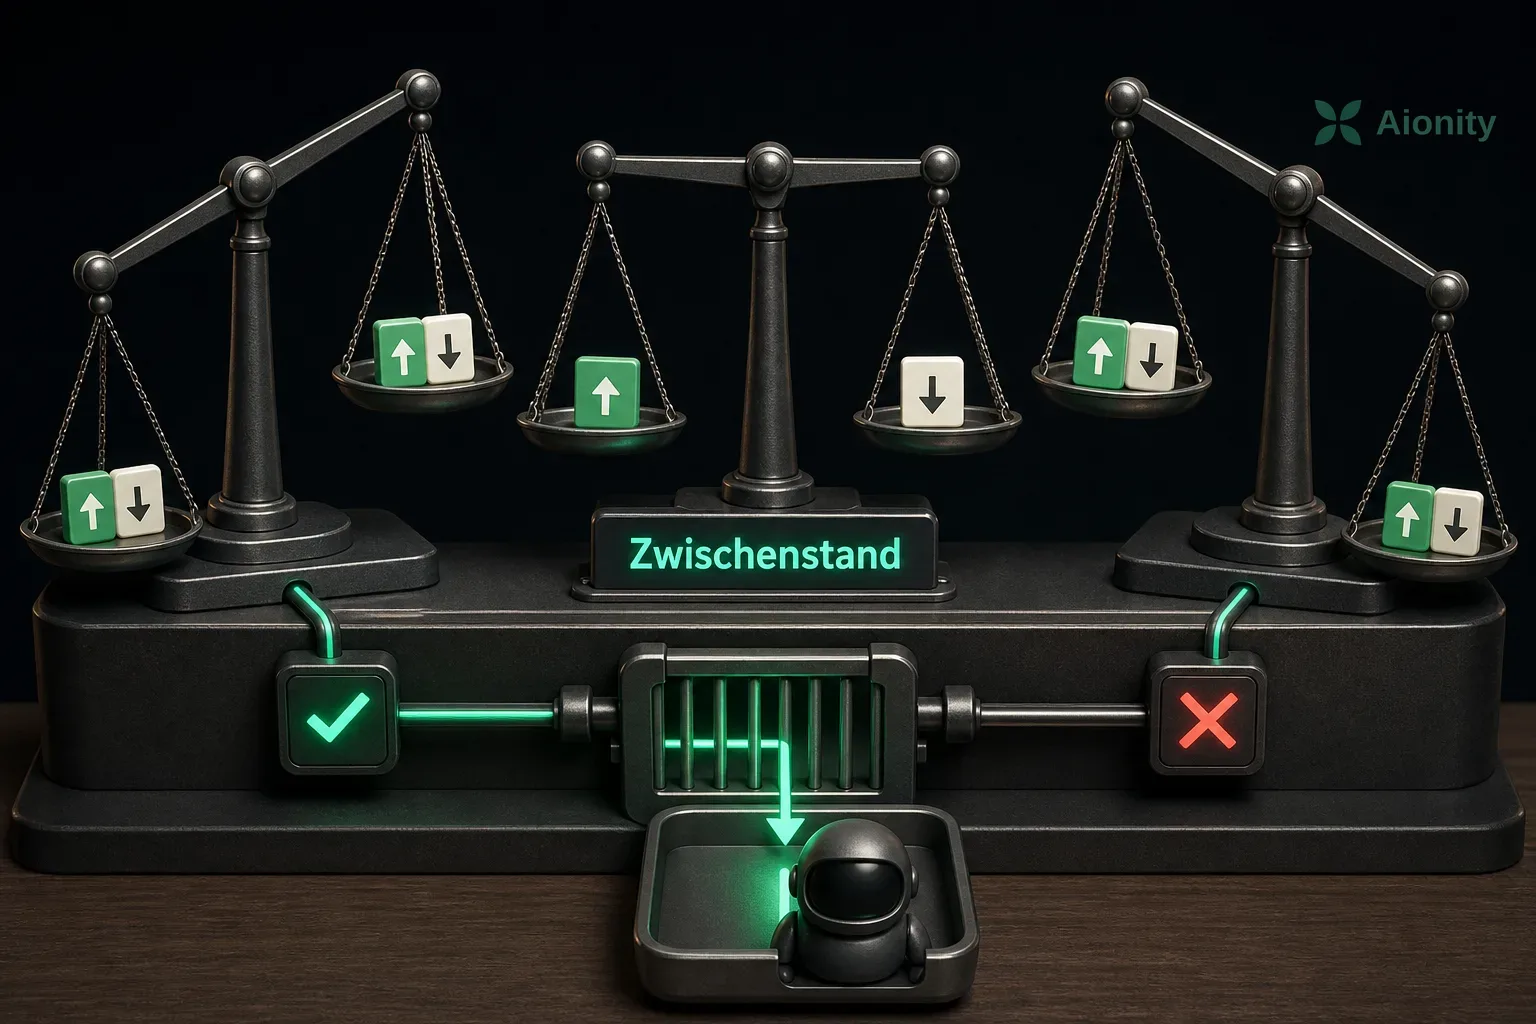
Bei der Policy-Shift-Distillation dienen Unterschiede zwischen den Log-Wahrscheinlichkeiten eines Lehrermodells vor und nach dem Reinforcement Learning (RL) als Trainingssignal. Dieses Signal wird auf Trajektorien angewendet, die das Schülermodell selbst erzeugt. Ein Vergleich nur der beiden Endpunkte zeigt jedoch nicht, ob sich die Präferenzen während des Trainings durchgehend in dieselbe Richtung entwickelt haben. Frühere und spätere Änderungen können sich verstärken oder teilweise aufheben.
Waypoint-guided On-Policy Distillation (Waypoint-OPD) ergänzt den Vergleich um einen Zwischenstand aus demselben RL-Trainingslauf. An den vom Schülermodell besuchten Präfixen werden damit frühe und späte Verschiebungen der relativen Aktionspräferenzen gegenübergestellt. Stimmen ihre Richtungen überein, kann die Methode die Verschiebung zwischen Ausgangs- und Endmodell übertragen. Zeigen sie in entgegengesetzte Richtungen, wird dieses Signal abgeschwächt. Gegenüber einer Übertragung allein anhand der Endpunkte benötigt das Verfahren laut Paper dafür einen zusätzlichen Scoring-Durchlauf mit einem eingefrorenen Lehrermodell.
Untersucht wurde die Methode mit RL-trainierten Qwen3-4B-Modellen als Lehrern. Als Schülermodelle kamen Qwen3-8B, Qwen3-14B und Qwen3-30B-A3B zum Einsatz; bewertet wurden mathematisches Schlussfolgern und Code-Aufgaben. Über alle sechs Kombinationen aus Aufgabenbereich und Schülermodell hinweg erzielte Waypoint-OPD unter den verglichenen Destillationsmethoden den höchsten durchschnittlichen Wert im jeweiligen Aufgabenbereich.
Zusätzliche Ablationen mit Qwen3-8B untersuchten die Gates, also die Filterung anhand der Richtungsübereinstimmung. Wurden die Gates entfernt oder ihre Zuordnungen durchmischt, sank die Leistung beim mathematischen Schlussfolgern. Das Paper führt die Ergebnisse als Hinweis darauf an, dass die Übereinstimmung früher und später Policy-Verschiebungen zur Gewichtung des Endpunktsignals genutzt werden kann. Die Tests beziehen sich auf mathematisches und programmierbezogenes Schlussfolgern mit den genannten Qwen3-Modellen.