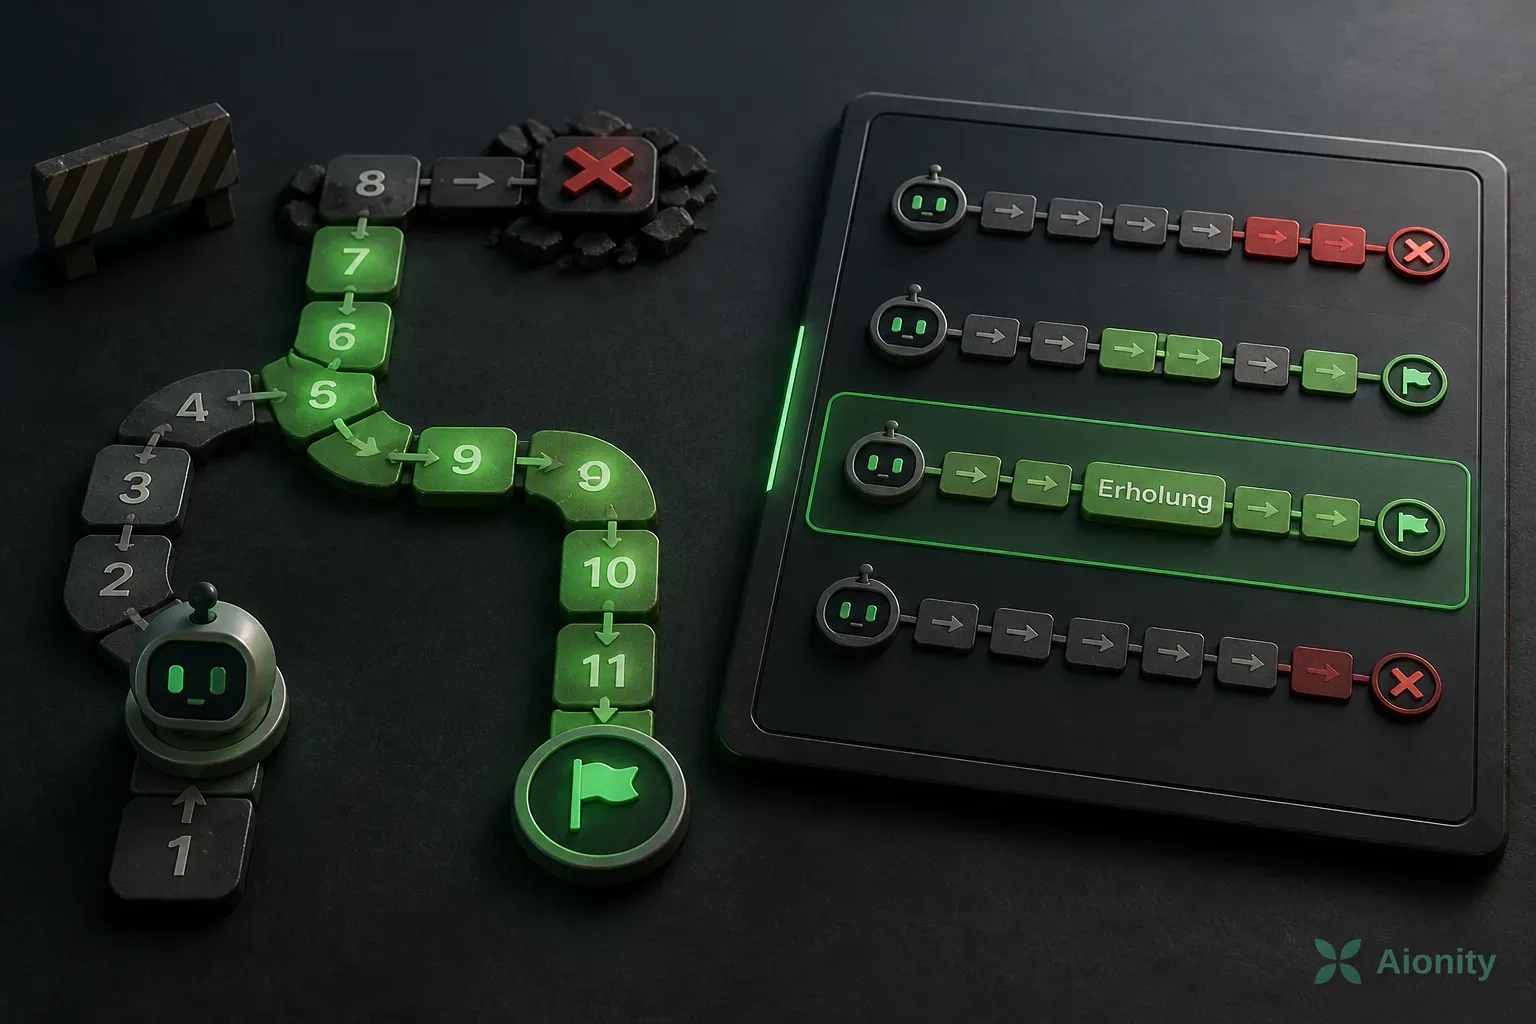
NVIDIA-Forschende entwickelten PivotOPD gemeinsam mit der Princeton University und der University of Maryland. Das Verfahren ist eine Trainingsmethode, kein eigenes Modell: Getestet wurde es mit Qwen3-1.7B und Qwen3-8B. Ein „pivotal mistake“ liegt vor, wenn eine Aktion den kürzesten Weg zur Lösung verlängert oder eine Aufgabe unlösbar macht. In 155 von 262 fehlgeschlagenen Abläufen von drei Qwen3-Modellgrößen trat mindestens ein solcher Fehler auf. Er geschah meist zwischen Zug 8 und 12 von insgesamt 30; danach vergingen weitere 18 bis 21 Züge ohne Erholung.
PivotOPD ergänzt gruppenbasiertes Reinforcement Learning um drei Schritte. Ein größeres Lehrermodell untersucht Abläufe nachträglich und schlägt kritische Züge samt passender Aktion vor. Eine präventive Distillation soll das Modell von seinem Fehler weglenken. Nach einem erkannten Fehler trainiert eine weitere Distillation Erholungsaktionen für bis zu K Züge. Auf ALFWorld lagen die erkannten Fehler in durchschnittlich 77,8 Prozent der fehlgeschlagenen Abläufe höchstens einen Zug vom Fehler des Orakels entfernt.
In Wiederholungen von 72 folgenreichen Fehlern gelang PivotOPD die Erholung in 72,7 Prozent der Fälle. Zum Vergleich: Das Basismodell erreichte 8,3 Prozent, Standard-OPD 20,3 Prozent und eine nur präventive Variante 45,8 Prozent. Im Schnitt brauchte PivotOPD 9,7 Züge für die Erholung; das optimale Ergebnis lag bei 6,2. Bei den drei Benchmarks ALFWorld, WebShop und Search-based QA erreichte das Verfahren laut den Tests im Durchschnitt die besten Werte gegenüber 13 Vergleichsmethoden. Mit Qwen3-8B lagen die Ergebnisse bei 93,0 Prozent auf ALFWorld, 47,4 Prozent auf Search-based QA und 81,9 Prozent Erfolgsrate auf WebShop.
Auch SWE-Bench Verified wurde getestet: Ein mit Nemotron-3.5-SFT trainierter Student verbesserte sich durch PivotOPD von 62,8 auf 66,0 Prozent. Standard-OPD erreichte 63,0 Prozent, das Lehrermodell 73,0 Prozent. Das Training lief auf NVIDIA-H100-Systemen. Für den Einsatz entstehen laut NVIDIA keine zusätzlichen Inferenzkosten. Auf ALFWorld betrug der Trainingsaufschlag gegenüber GRPO mit einem 1.7B-Modell und vier H100-GPUs bei K = 1 12,4 Prozent; bei K = 2 waren es 94,2 Prozent, unter anderem wegen zusätzlicher Wiederholungen in der Umgebung.