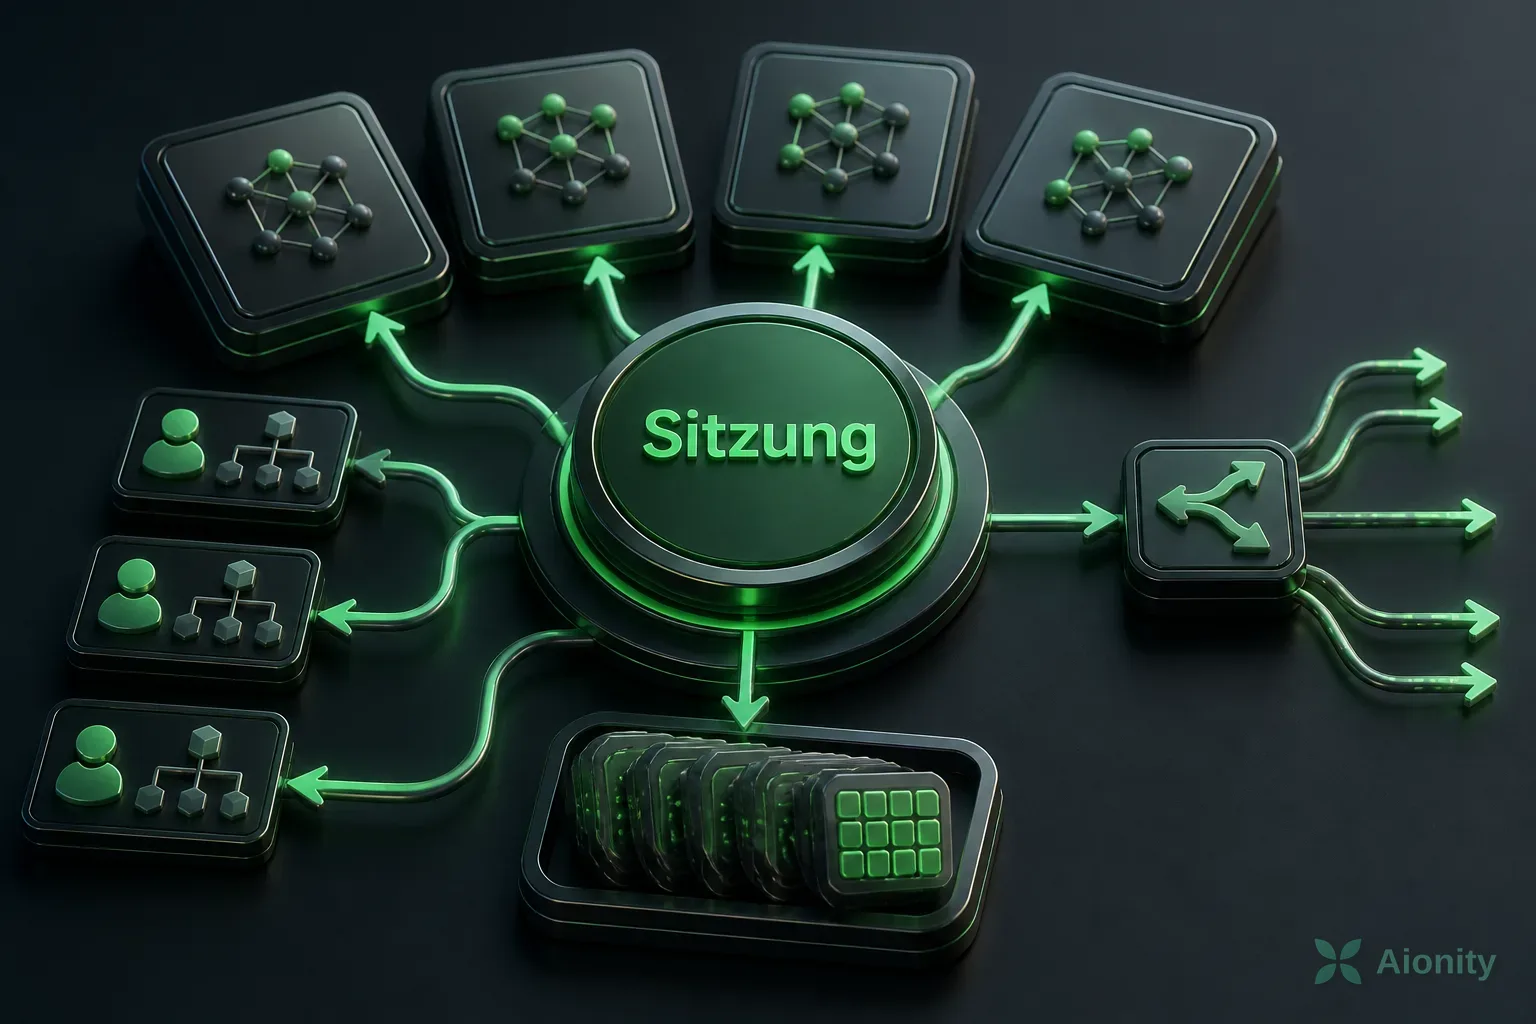
Agentische Abläufe erzeugen andere Lastmuster als einzelne Chat-Anfragen: Eine Sitzung kann mit einem umfangreichen Prompt starten, viele Modellaufrufe auslösen und parallel Subagenten nutzen. Während ein Agent auf ein Werkzeug wartet, bleibt sein Kontext im KV-Cache liegen. NVIDIA Dynamo will diese Abläufe deshalb nicht mehr nur als einzelne Anfragen behandeln, sondern als zusammenhängende Sitzung erfassen.
Dafür verwendet Dynamo eine stabile session_id, die alle Modellanfragen derselben Agenten-Ausführung verbindet. Untergeordnete Agenten können zusätzlich eine parent_session_id erhalten. So lassen sich Sitzungen und ihre Teilaufgaben miteinander verknüpfen. Claude Code, Codex und OpenCode werden laut NVIDIA Dynamo ohne zusätzliche Konfiguration erkannt, sofern sie ihre Sitzungskennungen über die vorgesehenen Header übermitteln. Für andere Harnesses bietet das Agent-Plugins-Repository Integrationen, die vorhandene Kennungen in den Header x-dynamo-session-id übertragen.
Die Kennung bildet die Grundlage für mehrere Optimierungen. Sitzungsbezogene Traces sollen Aktivitäten des Harness mit der Inferenzleistung verbinden und Wiederholungen sowie Simulationen ermöglichen. Beim Scheduling kann Dynamo laut Beschreibung Arbeitsmengen einer Sitzung berücksichtigen und an Werkzeuggrenzen Anfragen bremsen, um Cache-Verdrängung zu verringern. Ein experimenteller Index für gemeinsam genutzte Pools soll dem Router außerdem anzeigen, welcher KV-Cache in externen Speichern wiederverwendbar ist.
Für die Cache-Verwaltung beschreibt NVIDIA Dynamo auch einen Session-Prefix-Indexer und die vorgeschlagene Schnittstelle KvHint. Damit soll die Absicht einer sitzungsbezogenen Cache-Strategie über mehrere Speicherebenen weitergegeben werden; die eigentliche Ausführung bleibt den Inferenz-Engines überlassen. Die Optimierungen nutzen Sitzungsinformationen optional. Die beschriebenen Ansätze betreffen die Integration zwischen Dynamo und Engines wie vLLM und SGLang; der gemeinsame Pool-Indexer ist ausdrücklich experimentell, KvHint wird als Vorschlag vorgestellt.